Kurz gesagt: Europäische Sprachmodelle erreichen derzeit nicht die Qualität der führenden US-Modelle. Die entscheidende Frage ist deshalb nicht, welcher Anbieter, sondern über welchen Weg Sie die Modelle beziehen: direkt beim Modellanbieter mit europäischer Datenresidenz, über Azure mit Rechenzentren in Europa oder über einen Routing-Anbieter. Eine modell-agnostische Architektur mit RAG statt Fine-Tuning sorgt dafür, dass Sie den Anbieter jederzeit wechseln können.
IT-Leiter und Datenschutzbeauftragte stehen vor derselben Frage: Wir wollen KI einsetzen, aber können wir uns auf einen US-Anbieter verlassen? Gibt es europäische Alternativen? Was passiert, wenn sich die politische Lage ändert?
Die ehrliche Antwort ist unbequem: Es gibt derzeit keine europäischen Sprachmodelle, die mit den führenden US-Anbietern konkurrieren können. Aber die Frage ist falsch gestellt. Die eigentliche Entscheidung ist nicht "welcher Anbieter", sondern "über welchen Weg beziehe ich die gleichen Modelle". Und die Architektur, die dahinter steht, bestimmt, ob ein Unternehmen abhängig bleibt oder jederzeit wechseln kann.
Europäische Sprachmodelle können derzeit nicht mithalten
Das ist kein vorübergehender Zustand, sondern eine strukturelle Realität. Open-Source-Modelle, die auf eigenen Servern laufen könnten, liegen rund anderthalb Jahre hinter dem Stand der Technik. Diese Einschätzung hat sich über 18 Monate hinweg nicht verändert: Der Rückstand ist nicht schrumpfend, sondern stabil.
Das bedeutet: Wer die führende Qualität will, kommt an den kommerziellen Modellen der großen Anbieter nicht vorbei. OpenAI, Google (Gemini) und Anthropic (Claude) liefern die Modelle, die in der Praxis die besten Ergebnisse erzielen, insbesondere bei komplexen Aufgaben, die Reasoning und mehrstufige Verarbeitung erfordern.
Das bedeutet nicht, dass On-Premise-Lösungen generell sinnlos sind. Für einfache Aufgaben wie interne Dokumentenrecherche, Transkription von Meetings oder unkomplexe Wissensabfragen können Open-Source-Modelle durchaus ausreichen. Aber für anspruchsvolle Fachfragen, iterative Datenabfragen oder Aufgaben, die echtes "Nachdenken" des Modells erfordern, braucht man die führenden Modelle. Die Entscheidung ist: führende Qualität oder vollständige Kontrolle über die Infrastruktur. Beides gleichzeitig ist heute nicht realistisch.
Die eigentliche Frage: Bezugsweg, nicht Anbieter
Wenn die Modelle der großen Anbieter die beste Wahl sind, lautet die nächste Frage: Wie beziehe ich sie?
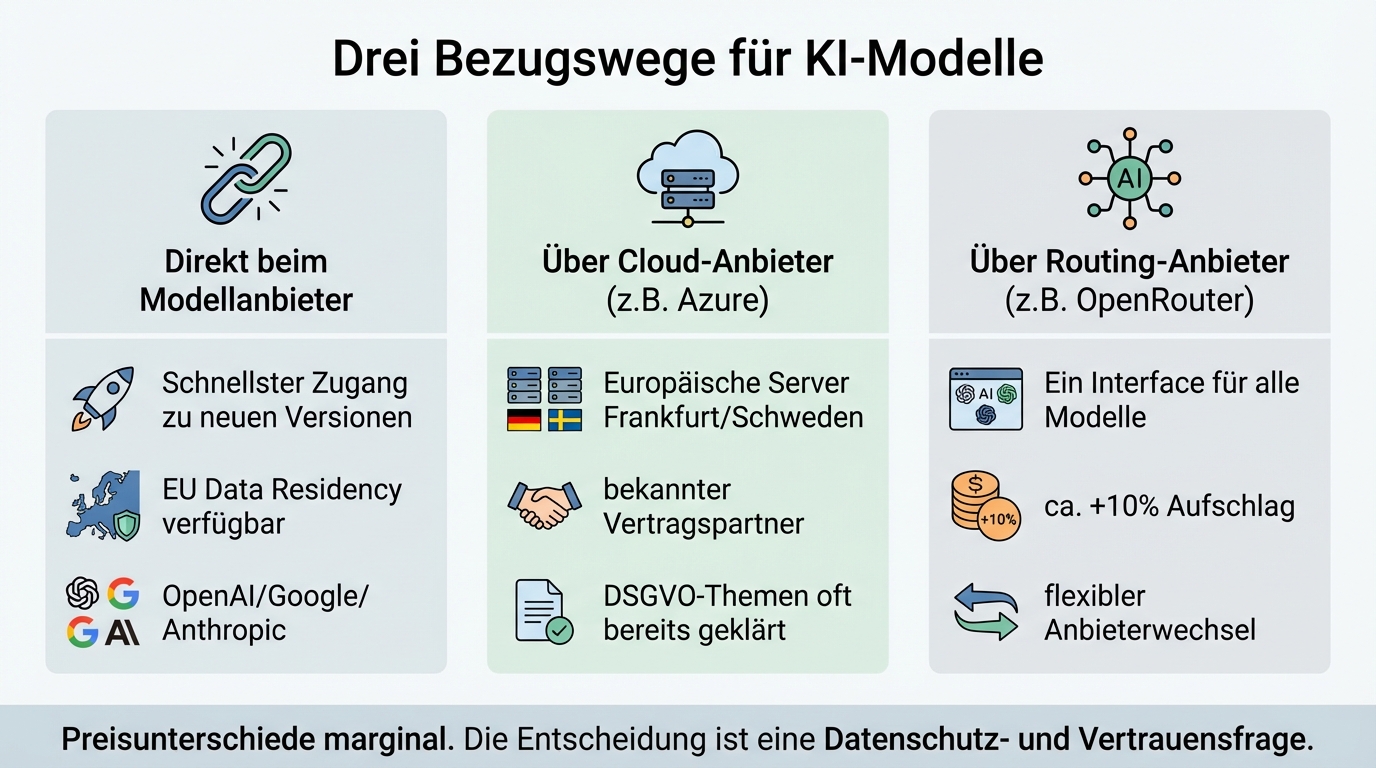
Drei Wege stehen zur Verfügung:
Direkt beim Modellanbieter. OpenAI, Google und Anthropic bieten API-Zugang zu ihren Modellen an. OpenAI bietet inzwischen auch für Business-Kunden europäische Datenresidenz an, ohne ein Enterprise-Agreement abschließen zu müssen. Der direkte Zugang ist in der Regel schneller bei neuen Modellversionen und besser verfügbar.
Über einen etablierten Cloud-Anbieter. Microsoft Azure hostet die OpenAI-Modelle auf europäischen Servern, beispielsweise in Frankfurt, Schweden oder der Schweiz. Google Cloud bietet Ähnliches für Gemini. Der Vorteil: In der Datenschutzerklärung steht "Microsoft" oder "Google", nicht "OpenAI aus San Francisco". Für Unternehmen mit sensiblen Stakeholdern kann das den entscheidenden Unterschied machen.
Über spezialisierte Routing-Anbieter. Dienste wie OpenRouter bündeln den Zugang zu verschiedenen Modellen über eine einheitliche API. Der Aufschlag liegt bei rund 10 Prozent auf die API-Kosten. Der Vorteil: ein einziger Vertrag, ein einziges Interface für alle Modelle, und bei manchen Anbietern die Möglichkeit, europäische Server zu wählen.
Die Preisunterschiede zwischen diesen Bezugswegen sind marginal. OpenAI direkt und Azure haben sehr vergleichbare Kosten. Die Bezugswegfrage ist eine Datenschutz- und Vertrauensfrage, keine Kostenfrage. On-Premise ist strukturell teurer, wegen nicht ausgelasteter Hardware, hoher Energiepreise und Fixkosten für den Betrieb.
Europäische Anbieter und Open Source: Wann sie passen
Neben den drei Bezugswegen für die führenden Modelle tauchen in Datenschutz-Diskussionen und Ausschreibungen regelmäßig zwei weitere Optionen auf.
Europäische Modellanbieter. Der bekannteste ist Mistral AI aus Frankreich. Für klar umrissene Aufgaben wie Klassifikation, Zusammenfassung oder das Auslesen von Dokumenten liefern europäische Modelle oft brauchbare Ergebnisse. Bei komplexen Fachfragen, die mehrstufiges Reasoning erfordern, liegen sie nach unserer Erfahrung hinter den führenden Modellen von OpenAI, Google und Anthropic.
Open-Source-Modelle bei europäischen Hostern oder auf eigener Hardware. Europäische Cloud-Anbieter betreiben offene Modelle in eigenen Rechenzentren und stellen sie per API bereit. Alternativ laufen sie on-premise im eigenen Serverraum. Das bringt die größtmögliche Kontrolle. Der Preis dafür ist die Qualität, die rund anderthalb Jahre hinter dem Stand der Technik liegt, und bei On-Premise zusätzlich die Fixkosten für Hardware und Betrieb.
Für die Praxis heißt das: Europäische und offene Modelle sind keine vollwertige Alternative für anspruchsvolle Aufgaben, aber eine sinnvolle Ergänzung. In einer modell-agnostischen Architektur lassen sich beide Welten kombinieren: ein europäisches oder selbst gehostetes Modell für einfache, hochvolumige oder besonders sensible Teilschritte, ein führendes Modell über einen europäischen Bezugsweg für die anspruchsvollen.
Azure ist oft die politisch klügere Wahl
Aus rein technischer Sicht wäre der direkte API-Zugang beim Modellanbieter die beste Option: schneller bei neuen Versionen, bessere Verfügbarkeit, weniger Zwischenschichten. Aber Technik ist nicht alles.
20 bis 30 Prozent der Stakeholder in deutschen Unternehmen reagieren stark auf den Namen in der Datenschutzerklärung. "OpenAI Limited, San Francisco" löst Diskussionen aus, unabhängig davon, ob die Daten tatsächlich in den USA verarbeitet werden. "Microsoft, Frankfurt" löst diese Diskussionen nicht aus, weil die meisten Unternehmen bereits eine etablierte Geschäftsbeziehung mit Microsoft haben und DSGVO-Themen mit dem Konzern längst geklärt sind.
Für Unternehmen mit hohen Vertraulichkeitsanforderungen ist Azure daher oft die pragmatisch bessere Empfehlung, auch wenn sie technisch einen kleinen Nachteil mit sich bringt. Der Name in der Datenschutzerklärung ist ein realer Faktor in der internen und externen Kommunikation.
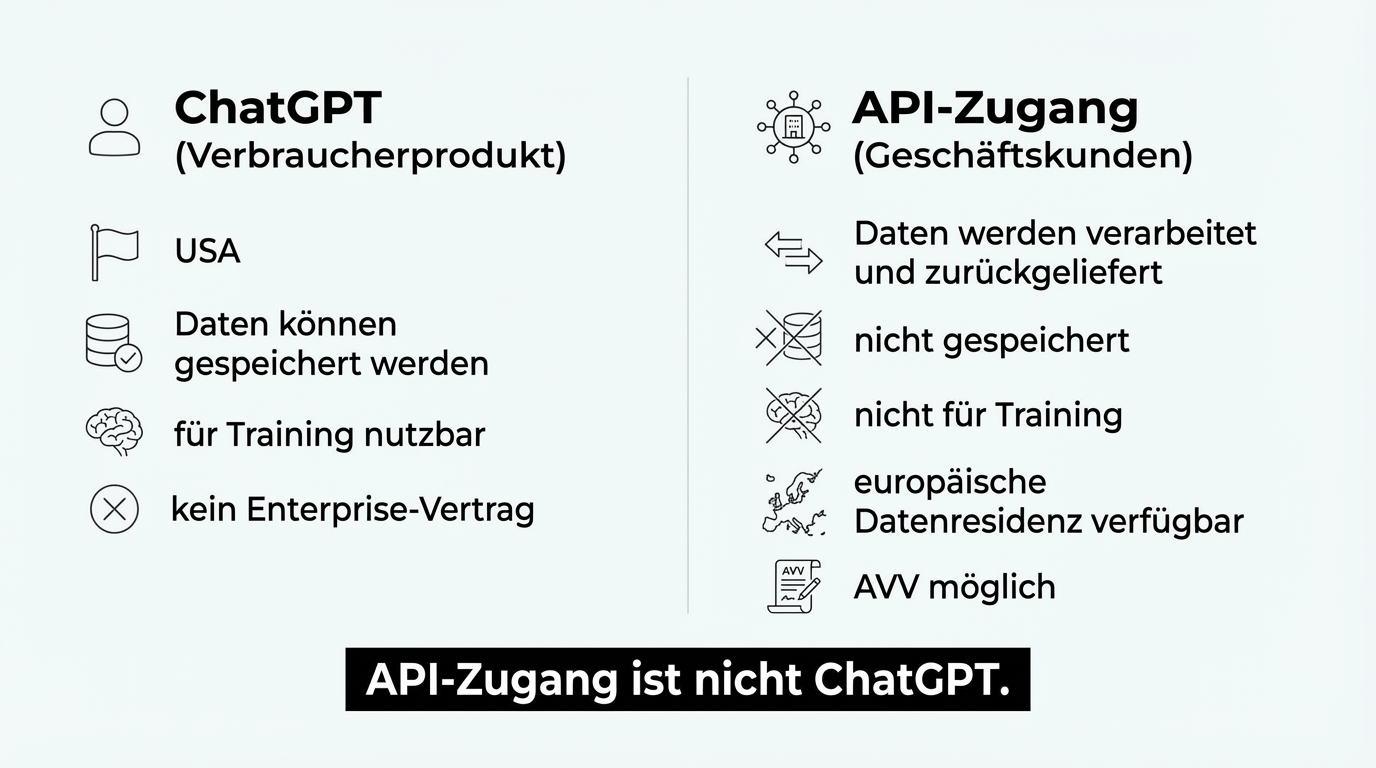
Wichtig dabei: Azure-gehostete Modelle sind nicht ChatGPT. Die Anwendung ChatGPT läuft in den USA und ist ein Verbraucherprodukt. Der API-Zugang zum reinen Modell (GPT) über Azure ist etwas vollkommen anderes: ein DSGVO-konformer Dienst, bei dem die Daten in der gewählten Region bleiben und nicht für das Training des Modells verwendet werden.
Modell-Agnostik ist keine theoretische Versicherung, sondern gelebte Praxis
Die Angst vor Abhängigkeit von einem einzelnen Anbieter ist berechtigt. Die Lösung liegt nicht darin, auf schwächere Alternativen auszuweichen, sondern in einer Architektur, die den Anbieter austauschbar macht.
Das Prinzip: Die eigentliche Software ist vom Modell entkoppelt. Das Sprachmodell ist ein austauschbares Modul, das über eine standardisierte Schnittstelle angebunden wird. Ob dahinter GPT, Gemini oder Claude arbeitet, ist eine Konfigurationsfrage, kein Architekturproblem.
In der Praxis wird ungefähr die Hälfte der Projekte direkt über OpenAI betrieben, die andere Hälfte über Azure. Es gibt Kunden, die verschiedene Modelle verschiedener Hersteller einsetzen, je nach Aufgabe. Und ja, es wurde in laufenden Projekten das Modell gewechselt. Bei gut geschriebenen Konfigurationen liegt der Aufwand für einen Modellwechsel bei ein bis zwei Wochen Anpassungsarbeit, und zwar auf der Inhaltsseite (Formulierungen optimieren), nicht auf der technischen Seite.
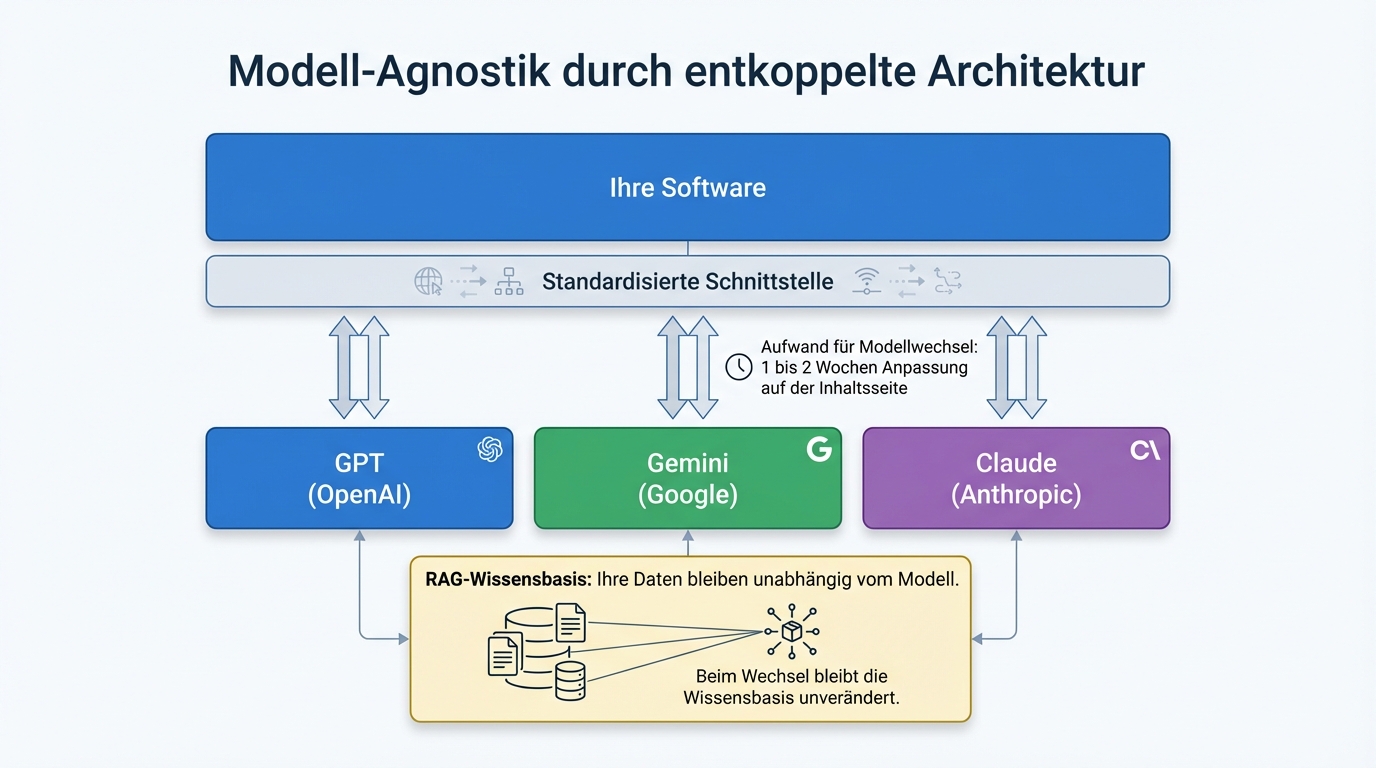
Diese Modell-Agnostik ist auch eine Risikostrategie: Wenn das Vertrauen in einen Anbieter verloren geht, ob durch einen Datenschutzskandal, eine Preiserhöhung oder eine politische Entscheidung, ist der Wechsel jederzeit möglich. Kein Vendor Lock-in, keine existenzielle Abhängigkeit. Worauf Sie deshalb bei der Auswahl eines KI-Dienstleisters achten sollten: Er sollte keinen einzelnen Anbieter fest verdrahten.
RAG statt Fine-Tuning: Die Architektur, die Unabhängigkeit ermöglicht
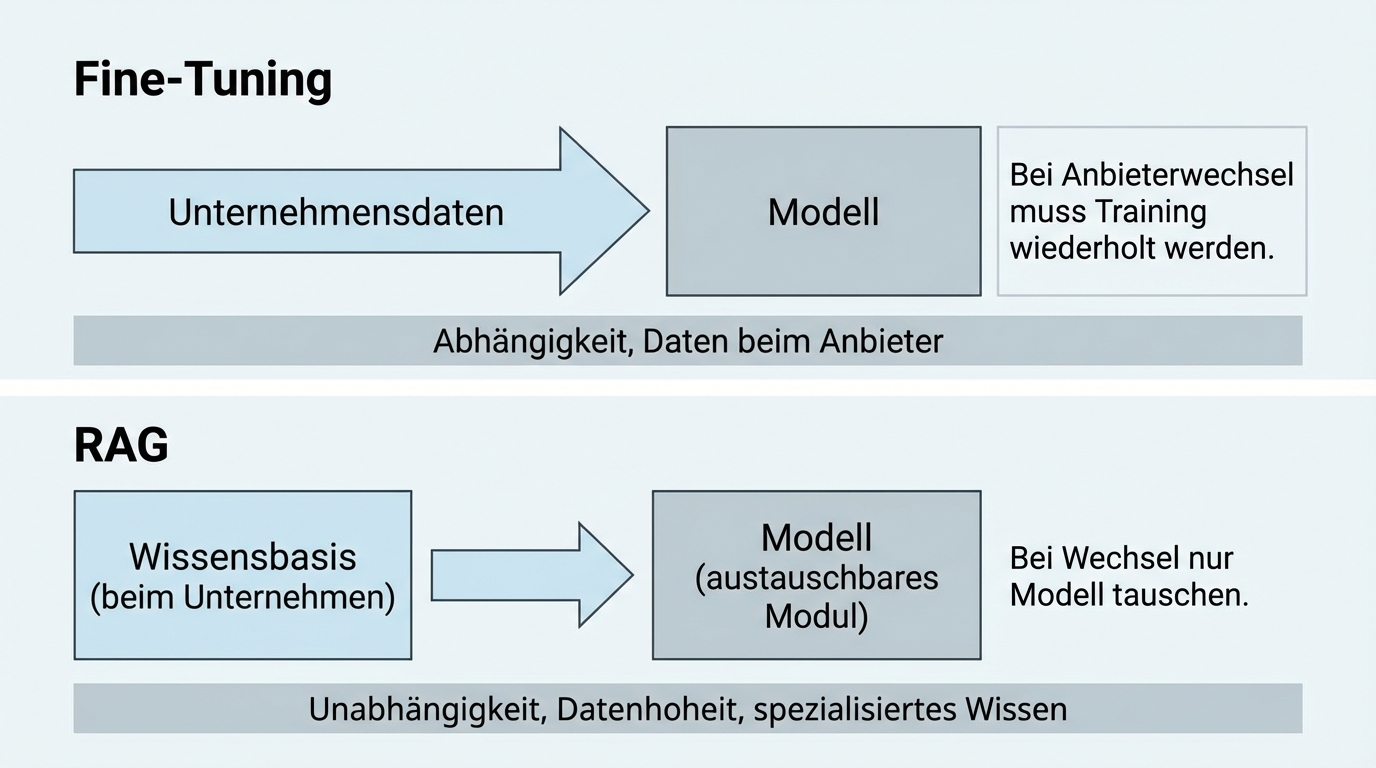
Der Schlüssel zur Modell-Agnostik liegt in der Architektur. Statt ein Sprachmodell mit eigenen Daten nachzutrainieren (Fine-Tuning), wird eine sogenannte RAG-Architektur eingesetzt: Die eigenen Daten bleiben in einer separaten, durchsuchbaren Wissensbasis. Bei jeder Anfrage werden die relevanten Informationen aus dieser Wissensbasis geholt und dem Modell als Kontext mitgegeben.
Drei Vorteile, die direkt mit der Anbieterfrage zusammenhängen:
Keine Abhängigkeit vom Modellhersteller. Beim Fine-Tuning wird das Modell selbst verändert. Wer den Anbieter wechselt, muss das Training wiederholen. Bei RAG bleibt die Wissensbasis unverändert, nur das Modell wird ausgetauscht.
Datenhoheit bleibt beim Unternehmen. Die eigenen Dokumente werden nicht an den Modellanbieter geschickt, um dort ins Training einzufließen. Sie bleiben in der eigenen Infrastruktur oder bei einem gewählten Hoster.
Spezialisiertes Wissen ohne Nachtraining. Die RAG-Architektur liefert validiertes Fachwissen mit nachvollziehbaren Quellenangaben. ChatGPT kennt keine internen Vorschriften, keine unveröffentlichten Gutachten, keine firmenspezifischen Prozesse. Ein RAG-System schon.
In der Weiterentwicklung arbeiten RAG und die neuen Reasoning-Fähigkeiten der Modelle zusammen: RAG liefert den Kontext, das Reasoning-Modul arbeitet darauf. Die Austauschbarkeit bleibt erhalten, weil die Kernfähigkeiten (Reasoning, automatisierte Werkzeugnutzung) bei allen zwei bis drei führenden Anbietern vorhanden sind.
Was "datenschutzkonform" in der Praxis bedeutet
Die DSGVO-Debatte bei KI-Lösungen wird oft emotional statt sachlich geführt. Drei Punkte schaffen Klarheit:
API-Zugang ist nicht ChatGPT. Wer die API eines Modellanbieters nutzt, sendet Daten an einen Dienst, der sie verarbeitet und das Ergebnis zurückliefert. Die Daten werden nicht gespeichert und nicht für das Training verwendet. Das ist ein fundamental anderer Vorgang als die Nutzung von ChatGPT als Verbraucherprodukt.
Europäische Datenresidenz ist verfügbar. Sowohl Azure als auch OpenAI Business bieten inzwischen die Möglichkeit, Daten ausschließlich auf europäischen Servern zu verarbeiten. Die Einschränkung, dass dafür ein Enterprise-Vertrag nötig war, hat sich durch die Marktentwicklung aufgelöst.
Selbst hosten ist kein Sicherheitsgewinn. Wer argumentiert, On-Premise sei sicherer, unterstellt, dass die eigene IT-Security-Abteilung kompetenter ist als die der großen Cloud-Anbieter. Für die meisten mittelständischen Unternehmen ist das eine fragwürdige Annahme. Die vertrauenswürdigste Option ist oft der Cloud-Anbieter, dem man am meisten vertraut, kombiniert mit einer Architektur, die den Wechsel jederzeit ermöglicht.
Wie sich Datenschutz von Anfang an in die Architektur einbauen lässt, von der Serverregion bis zur AVV-Kette, beschreibt der Beitrag DSGVO-konforme KI im Unternehmen.
Was die Entscheidung erfordert
Die Modellwahl ist keine existenzielle Entscheidung. Sie ist eine pragmatische Abwägung, die in zwei Wochen getroffen werden kann. Drei Fragen reichen:
Wie sensibel sind Ihre Stakeholder? Wenn 20 Prozent Ihrer Mitglieder, Kunden oder Mitarbeiter auf "OpenAI, San Francisco" in der Datenschutzerklärung reagieren, nehmen Sie Azure oder einen europäischen Hoster. Der technische Nachteil ist minimal, der politische Vorteil erheblich.
Wie komplex sind Ihre Aufgaben? Für einfache Dokumentenrecherche und Transkription kann On-Premise ausreichen. Für Fachfragen mit Reasoning, mehrstufiger Verarbeitung und automatisierter Werkzeugnutzung brauchen Sie die führenden Cloud-Modelle.
Wie wichtig ist Ihnen Unabhängigkeit? Eine modell-agnostische Architektur mit RAG statt Fine-Tuning gibt Ihnen die Freiheit, jederzeit den Anbieter zu wechseln. Das kostet im Aufbau nicht mehr, sichert aber langfristig gegen Abhängigkeit ab.
Häufige Fragen zu OpenAI-Alternativen
Gibt es eine europäische Alternative zu OpenAI?
Ja, etwa Mistral AI aus Frankreich oder Open-Source-Modelle, die europäische Hoster in eigenen Rechenzentren betreiben. Für einfache Aufgaben reichen sie oft aus, bei komplexen Fachfragen erreichen sie die Qualität der führenden US-Modelle derzeit nicht. Pragmatischer ist meist, die führenden Modelle über einen europäischen Bezugsweg zu nutzen, zum Beispiel über Azure in einem EU-Rechenzentrum.
Ist die Nutzung von OpenAI DSGVO-konform?
Der API-Zugang lässt sich DSGVO-konform nutzen, wenn europäische Datenresidenz gewählt und ein Auftragsverarbeitungsvertrag abgeschlossen ist. Über die API übermittelte Daten werden nicht für das Training der Modelle verwendet. Das Verbraucherprodukt ChatGPT ist davon zu unterscheiden und für vertrauliche Unternehmensdaten nicht der richtige Weg.
Was ist der Unterschied zwischen OpenAI und Azure OpenAI?
Es sind dieselben Modelle. Bei Azure betreibt Microsoft sie in eigenen Rechenzentren, etwa in Frankfurt, Schweden oder der Schweiz, und Microsoft ist Ihr Vertragspartner. Neue Modellversionen erscheinen beim direkten Zugang meist etwas früher, die Kosten sind sehr ähnlich. Der wesentliche Unterschied liegt beim Namen in der Datenschutzerklärung.
Kann man ein Sprachmodell selbst hosten?
Ja, mit Open-Source-Modellen auf eigener Hardware oder bei einem europäischen Hoster. Für interne Dokumentenrecherche, Transkription oder einfache Wissensabfragen kann das ausreichen. Für anspruchsvolle Aufgaben fehlt die Qualität, und der Betrieb ist wegen nicht ausgelasteter Hardware und Fixkosten strukturell teurer als die Cloud.
Wie aufwendig ist ein Wechsel des KI-Anbieters?
Mit einer modell-agnostischen Architektur und RAG statt Fine-Tuning liegt der Aufwand bei ein bis zwei Wochen. Die Arbeit entsteht dabei vor allem auf der Inhaltsseite, beim Nachschärfen von Formulierungen, nicht in der Technik.
Wer unterstützt bei der Wahl des richtigen KI-Bezugswegs?
Deyan7 baut KI-Lösungen grundsätzlich modell-agnostisch. Ungefähr die Hälfte unserer Projekte läuft direkt über OpenAI, die andere Hälfte über Azure. Wir empfehlen den Bezugsweg, der zu Ihren Datenschutzanforderungen und Stakeholdern passt, und halten den Wechsel offen. Was ein solches Projekt kostet, steht in Was kostet ein KI-Projekt?